[모아야 보입니다 #3/4] '잘 돌아간다'와 '일을 잘한다'는 다릅니다
AI 에이전트의 정상 작동과 업무 성과는 다릅니다. 비용·기술 성능·효과성·비즈니스 임팩트라는 네 가지 질문으로 '토큰 루팡'을 가려내고, 같은 기준으로 AI ROI를 평가하는 방법을 소개합니다.
오류 하나 없이 돌아가는 에이전트도 회사에 손해를 끼칠 수 있습니다.
에이전트를 제대로 평가하기 위한 4가지 질문과, 비용만 쓰는 '토큰 루팡'을 가려내는 법을 정리했습니다.
지난 2편에서는 "측정하려면 먼저 모아야 한다"는 이야기를 했습니다. 그런데 모은 다음에도 질문이 하나 남습니다.
무엇을 기준으로 재야 할까요?
출근 잘하는 신입이 일도 잘할까?
신입사원 한 명을 떠올려 보겠습니다. 매일 9시 정각에 출근하고, 컴퓨터는 하루 종일 켜져 있고, 메신저 답장도 빠릅니다. 그렇다면 이 사람이 일을 잘한다고 할 수 있을까요? 그렇지 않습니다. 출근 기록은 '자리에 성실히 있다'는 것만 보여줄 뿐, 맡은 일을 잘 해내는지는 알려주지 않습니다.
AI 에이전트도 똑같습니다.서버가 정상이고, 응답 속도가 빠르고, 오류 로그가 깨끗하다고 해서 그 에이전트가 일을 잘하고 있다는 뜻은 아닙니다.
79%가 겪은 '정상 작동하는 사고'
이번 조사에서 가장 눈길을 끈 숫자는 이것입니다. CIO의 79%가 기술적으로는 정해진 범위 안에서 정상 작동했는데도 비즈니스 의도나 정책, 기대에 어긋나게 행동한 AI 에이전트를 겪었다고 털어놨습니다.
31%는 그 일이 고객, 재무, 컴플라이언스, 운영 측면의 실제 피해로 이어졌다고 답했습니다.
예를 들어 보겠습니다. 고객 문의에 답하는 에이전트가 응답 속도와 처리 건수 모두 목표를 넘겼습니다.
그런데 알고 보니 환불 규정을 회사 방침보다 너그럽게 안내해 비용이 새고 있었다면 어떨까요?
시스템 모니터링 화면에는 아무 경고도 뜨지 않습니다.기술적으로는 '정상'이기 때문입니다.
더 큰 문제는 대응 속도입니다. 문제가 생긴 에이전트를 당일 안에 멈추고 격리하지 못한다는 CIO가 10명 중 6명꼴이었고, 1~2시간 안에 할 수 있다는 곳은 10%에 그쳤습니다.
에이전트는 사람이 알아차리고 개입할 때까지 계속 일합니다. 잘못된 방향으로도 말입니다.
사후에 설명하는 일도 쉽지 않습니다. CIO의 66%는 규제 기관이 당장 내일 요구한다면 에이전트 의사결정의 처음부터 끝까지 이력을 내놓을 자신이 완전하지는 않다고 답했습니다.
'토큰 루팡'을 찾아라
반대의 경우도 있습니다.
사고는 치지 않지만 토큰과 컴퓨팅 비용만 꾸준히 쓰면서 정작 업무 성과에는 별 기여를 못 하는 에이전트입니다.
월급만 받고 일은 안 하는 '월급 루팡'에 빗대'토큰 루팡'이라 부를 만합니다.
에이전트가 수백 개로 늘어나면 이런 에이전트를 감으로 찾아내기는 불가능에 가깝습니다.
매일 수천 건의 문서를 요약하지만 그 요약을 읽는 사람이 거의 없는 에이전트, 업무가 바뀐 뒤에도 습관처럼 계속 돌아가는 에이전트가 대표적입니다.
2편에서 본 것처럼 CIO의 38%가 '에이전트 증가로 생기는 숨은 비용'을 걱정하는 이유가 여기에 있습니다.
에이전트를 평가하는 4가지 질문
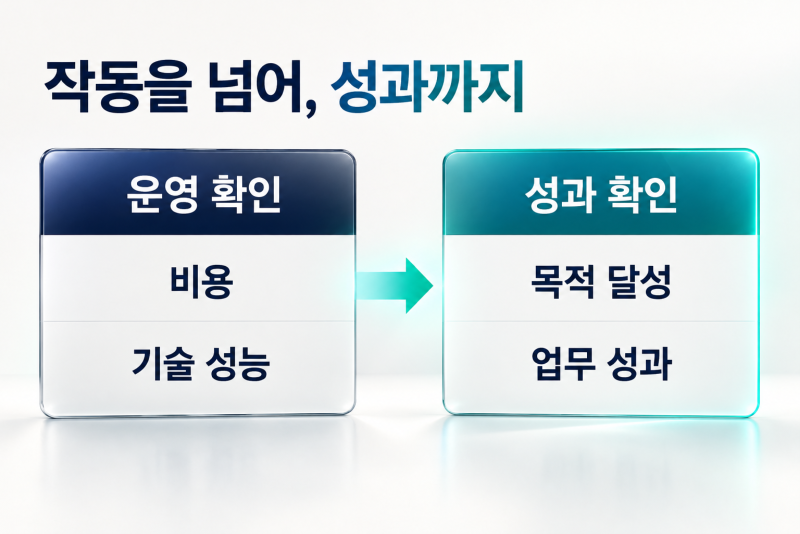
그렇다면 에이전트가 진짜 일을 잘하는지는 어떻게 알 수 있을까요? 이번 포스팅에서는 네 가지 질문으로 정리해 보겠습니다.
✔️비용: 무엇을, 어디서, 얼마나 쓰고 있나?
✔️기술 성능: 안정적으로, 예상대로 작동하고 있나?
✔️에이전트 효과성: 만들어진 목적에 맞는 일을 제대로 해내고 있나?
✔️비즈니스 임팩트: 이 에이전트가 맡은 업무의 성과가 실제로 좋아졌나?
지금 많은 기업이 측정하는 것은 1번과 2번까지입니다. 클라우드 청구서와 시스템 모니터링 도구가 알려주는 영역입니다.
하지만 ROI를 이야기하려면 3번과 4번까지 가야 합니다.CIO의 72%가 모든 에이전트의 운영 성능과 비즈니스 성과를 일관되게 측정하지 못한다는 건, 바로 이 3·4번 구간이 비어 있다는 뜻입니다.
1편에서 마케팅 캠페인과 달리 에이전트에는 KPI가 정해져 있지 않은 경우가 많다고 했습니다.
3·4번이 어려운 이유가 바로 여기에 있습니다. 에이전트마다 '잘했다'의 기준이 다르기 때문입니다.
계약서 검토 에이전트는 위험 조항을 빠짐없이 짚었는지가, 영업 지원 에이전트는 제안서 작성 시간이 얼마나 줄었는지가 기준이 됩니다.정확도, 업무 완료율, 사람이 다시 손봐야 하는 비율처럼 에이전트별 KPI를 미리 정해 두지 않으면, 나중에 성과를 증명하고 싶어도 비교할 기준선 자체가 없습니다.
같은 기준, 같은 저울
중요한 포인트가 하나 더 있습니다. 네 가지 질문을 에이전트마다 다른 방식으로 재면 비교가 안 된다는 점입니다.
영업팀 에이전트는 엑셀로, 고객센터 에이전트는 별도 대시보드로, 외부에서 도입한 에이전트는 공급사 리포트로 평가한다면 어떤 에이전트에 투자를 늘리고 어떤 에이전트를 정리할지 판단할 수 없습니다.
그래서 평가는 모으기와 짝을 이뤄야 합니다. 직접 만든 에이전트든 외부에서 도입한 에이전트든 한곳에 모아 같은 기준으로 비교할 수 있어야, 비로소 "이 에이전트는 비용 대비 잘하고 있다"는 말을 근거와 함께 할 수 있습니다.
다음 편 예고
정리하면, 에이전트의 ROI를 증명하려면 한곳에 모으고, 통제할 수 있어야 하고, 꾸준히 관리하면서, 같은 기준으로 평가해야 합니다. 마지막 4편에서는 이 네 가지를 한곳에서 풀어내는 방법, 인포유앤컴퍼니가 OneOI로 그리고 있는 에이전트 운영의 다음 단계를 소개하겠습니다.
에이전트마다 같은 기준으로 성과를 비교하는 방법이 궁금하다면?
👇👇👇👇👇👇
[웨비나 사전등록] AI 투자의 ROI, 모아야 보입니다:
흩어진 AI를 자산으로 바꾸는 측정 가능한 에이전트 전략
출처: Dataiku·The Harris Poll, Global AI Confessions Report: CIO Edition 2026(2026년 7월 9~29일, 8개국 연 매출 5억 달러 이상 기업 CIO 685명 온라인 조사, 한국 100명).
